Hvad kræver lokal AI på din egen maskine?
Du kan køre en sprogmodel uden internet og uden at sende et eneste ord videre. Men hukommelsen i din maskine sætter grænserne — her er hvad du skal vide, før du går i gang.
Du behøver ikke en internetforbindelse for at bruge en sprogmodel. Lokal AI betyder, at modellen ligger som en fil på din egen computer og regner løs dér — uden at et eneste ord bliver sendt videre til en server et andet sted i verden. Teknisk set er det blevet overraskende ligetil at komme i gang. Men der følger en regning i form af hardware, tålmodighed og lidt teknisk nysgerrighed, og den er værd at kende, før du henter den første gigabyte ned.
Hvad sker der egentlig, når modellen kører hjemme hos dig?
En sprogmodel er grundlæggende en meget stor samling tal, som kaldes parametre. De beskriver tilsammen, hvordan modellen gætter det næste lille stykke tekst ud fra alt det, den har fået serveret indtil nu. Bruger du en tjeneste i skyen, ligger de tal på en kraftig server, og din tekst rejser frem og tilbage over nettet. Kører du lokalt, hentes den samme talsamling ned på din disk, og hele udregningen foregår i din egen processor eller dit grafikkort.
Selve udregningen kaldes inferens. Den skal ske hurtigt nok til, at svaret drypper ud i et tempo, du gider følge med i. Det er præcis dér, hardwaren afgør, om oplevelsen bliver behagelig eller decideret irriterende.
Hukommelsen er flaskehalsen — ikke processorens hastighed
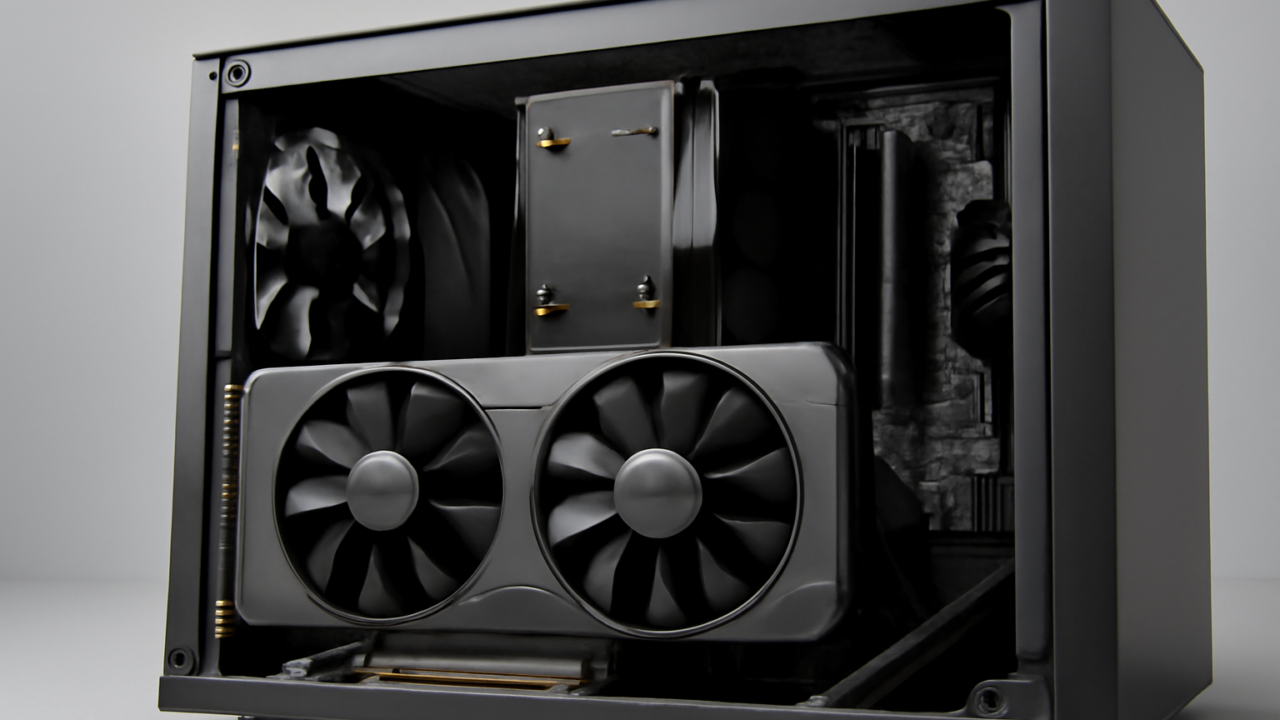
Den vigtigste enkeltfaktor er plads i hukommelsen. Modellen skal kunne ligge i maskinens arbejdshukommelse (RAM) eller allerhelst i grafikkortets egen hukommelse (VRAM). Kan den ikke være der, må computeren hele tiden hente stumper ind fra disken, og så falder hastigheden dramatisk. Det er derfor, at en ellers hurtig maskine kan føles håbløs, så snart modellen bliver en tand for stor.
- Hukommelse frem for alt: jo flere parametre en model har, jo mere plads kræver den. De største åbne modeller kan slet ikke være i hukommelsen på en almindelig bærbar.
- Grafikkort: et dedikeret grafikkort med rigeligt VRAM giver typisk markant hurtigere svar end processoren alene. Ligger modellen helt i VRAM, mærkes forskellen med det samme.
- Maskiner med samlet hukommelse: nyere computere, hvor processor og grafikdel deler én stor pulje hukommelse, kan ofte køre større modeller end et selvstændigt grafikkort med sparsom VRAM.
- Diskplads: modelfiler fylder meget, og du ender næsten altid med flere versioner liggende, mens du eksperimenterer.
- Køling og strøm: længere kørsler presser maskinen mærkbart. Bærbare skruer typisk ned for ydelsen på batteri, så svarene bliver langsommere, når stikket ryger ud.
Kvantisering: modellen på slankekur
Du støder hurtigt på begrebet kvantisering. Det betyder kort fortalt, at modellens mange tal gemmes med mindre præcision end oprindeligt — lidt som at gemme et foto med hårdere komprimering. Filen bliver væsentligt mindre, den kan pludselig være i hukommelsen, og svarene kommer hurtigere. Til gengæld mister modellen en smule kvalitet. Ved moderat kvantisering er tabet ofte svært at bemærke i praksis, mens det bliver tydeligt, når man skruer for hårdt ned.
Pro-tip: Begynd med den mindste model, der faktisk løser din opgave — ikke den største, din maskine lige akkurat kan klemme ind. En hurtig, lidt enklere model, du gider bruge hver dag, er langt mere værd end en tung model, du opgiver efter en uge.
Det, der taler for at flytte arbejdet hjem
- Dine data bliver på maskinen. Det er relevant for fortrolige noter, personfølsomme oplysninger, udkast og alt det, du ikke ville sende til en fremmed server.
- Det virker uden internet — i toget, i sommerhuset eller på et netværk, hvor eksterne tjenester er lukket af.
- Du bestemmer over versionen. Modellen ændrer sig ikke fra den ene dag til den anden, fordi en leverandør har opdateret noget bag kulisserne.
- Ingen kvoter, intet målt forbrug og ingen begrænsning på, hvor mange forespørgsler du sender.
- Du lærer meget om, hvordan teknologien faktisk fungerer — og det gør dig til en bedre bruger, også af de tjenester, der kører i skyen.
Og her er begrænsningerne, du bør regne med
- Kvalitet: modeller, der kan køre på almindeligt udstyr, er sjældent på niveau med de allerstørste tjenester, når opgaven bliver kompleks eller lang eller kræver præcis faktuel viden.
- Hastighed: på beskeden hardware kan svarene komme så langsomt, at du mister lysten, især ved lange tekster.
- Kontekstvinduet koster: jo mere tekst modellen skal holde styr på ad gangen, jo mere hukommelse bruger den. Lange dokumenter er ofte det, der vælter læsset.
- Vedligehold: du er selv driftsafdeling. Opdateringer, drivere, diskplads og fejlfinding lander på dit bord.
- Hallucinationer forsvinder ikke. En lokal model finder på ting lige så gerne som en model i skyen — nogle gange oftere.
- Dansk kan halte: mange åbne modeller er trænet med en overvægt af engelsk, så dansk sprogforståelse og stavning kan være svagere end forventet.
Kort forklaret
- Parametre: modellens indre tal. Antallet angives i milliarder og siger noget om både størrelse og hukommelsesbehov.
- Kvantisering: at gemme parametrene med lavere præcision, så modellen fylder mindre og kører hurtigere — på bekostning af en smule kvalitet.
- Kontekstvindue: hvor meget tekst modellen kan have i hovedet på én gang, inklusive både dit spørgsmål og dens eget svar.
- Inferens: selve udregningen, der producerer svaret. Det er den, der belaster maskinen.
- Token: den lille sproglige bid, som modellen regner i. Et dansk ord fylder ofte flere tokens.
En realistisk vej ind i lokal AI
- Afklar formålet først. Skal modellen omskrive tekst, opsummere noter, hjælpe med kode eller bare være et eksperiment? Kravene er vidt forskellige.
- Kig på din maskines hukommelse, før du kigger på modeller. Det er det tal, der afgør, hvad der overhovedet er muligt.
- Vælg bevidst en lille model til den første test, så du får noget til at virke frem for at fejlsøge i timevis.
- Test med dine egne, rigtige opgaver — ikke med de eksempler, der følger med. Det er der, forskellene viser sig.
- Vurder oplevelsen frem for tekniske måletal: kom svaret hurtigt nok, og var det brugbart nok til, at du ville gøre det igen?
- Skalér op gradvist. Prøv en større eller en mindre kvantiseret model, når du ved, hvor grænsen for din tålmodighed og din hardware går.
Lokalt er ikke automatisk sikkert
At data bliver på maskinen, løser et privatlivsproblem — men det er ikke det samme som sikkerhed. Du henter både programmer og modelfiler ned fra internettet, og de bør komme fra etablerede, anerkendte kilder på samme måde som al anden software. Hold styresystemet opdateret, tag backup af det, du ikke vil miste, og vær opmærksom på, at en model, der kan læse dine filer, også får adgang til indholdet af dem. Søger du generelle råd om sikker adfærd og aktuelle trusler, er Center for Cybersikkerhed og myndighedernes vejledninger om digital sikkerhed det rigtige sted at starte.
Opsummering
Lokal AI er blevet fuldt realistisk for almindelige brugere med lidt teknisk mod. Hukommelsen i din maskine — især grafikkortets — afgør, hvilke modeller der giver mening, og kvantisering er det håndtag, der gør større modeller mulige på bekostning af en smule kvalitet. Fordelene er tydelige: dine data forlader ikke computeren, det virker offline, og du bestemmer selv over versionerne. Prisen er lavere kvalitet end hos de største tjenester, langsommere svar på beskeden hardware, svingende dansk og et vedligehold, du selv står for. Start småt, test med dine egne opgaver, og skalér først op, når du ved, hvad din maskine faktisk kan bære.
Relaterede guides
Tilbudsforespørgsel med AI: skabelon og 5 faldgruber
Et AI-værktøj kan hjælpe dig med at beskrive opgaven klart, men kun hvis du selv leverer fakta. Her…
Pallesofa i 3D: 7 ting, du bør vide, før du saver
Paller er billige at få fat i, men et forkert snit kan ikke gøres om. Med en enkel…
Årsplan for vedligehold af huset: Lad AI lægge planen
Tagrender, der løber over, og en terrasse, hvor du ikke kan huske, hvornår den sidst fik olie? En…